首页 / PaperMind
PaperMind
科研文献阅读网站(已上线)
在浏览器里管理和精读 PDF 文献,文件不出本机;AI 助手经服务端代理调用模型。
要解决的问题
读文献时,PDF、筛选判断、笔记和提问散在不同工具里;同时不希望把未发表的资料上传到第三方服务器。
核心功能
- 拖入 PDF 即入库,文件只保存在浏览器 IndexedDB
- 按阅读状态(待筛选 / 待读 / 精读中 / 已读完 / 已放弃)和类型管理
- “三分钟筛选”五问,帮助判断是否值得精读
- 阅读器旁的 AI 助手:按当前页或全文提问,回复可记入笔记或问题库
- 中英文界面切换、深浅色主题
实际完成情况
| 公网运行中,Cloudflare Pages + Workers |
| 服务端代理 14 项安全测试通过(2026-11-19 复跑) |
| AI 助手通过共享模型真实回答(2026-11-19 实测,约 13 秒) |
| 2026-11-19 审查发现并修复阅读器两处缺陷(缺失函数导致 AI 面板报错;内容安全策略拦截 PDF 加载),已上线 |
| 未做用户账号与跨设备同步;数据随浏览器存储,需手动导出备份 |
系统架构
浏览器PDF 与笔记存 IndexedDB
→pdf.js渲染与取文本
→Workers 代理固定上游 · 限流 · 熔断
→GLM-4-Flash回答问题
浏览器只发送消息内容;上游地址、模型和共享密钥都固定在服务端。单 IP 每分钟 6 次、每天 60 次,全站每天 1000 次;上游连续失败 5 次熔断 60 秒;日志不记录论文和对话正文。
主要技术
HTML / CSS / 原生 JavaScript、pdf.js、IndexedDB;Cloudflare Pages、Workers、D1(限流计数);智谱 GLM-4-Flash
运行截图
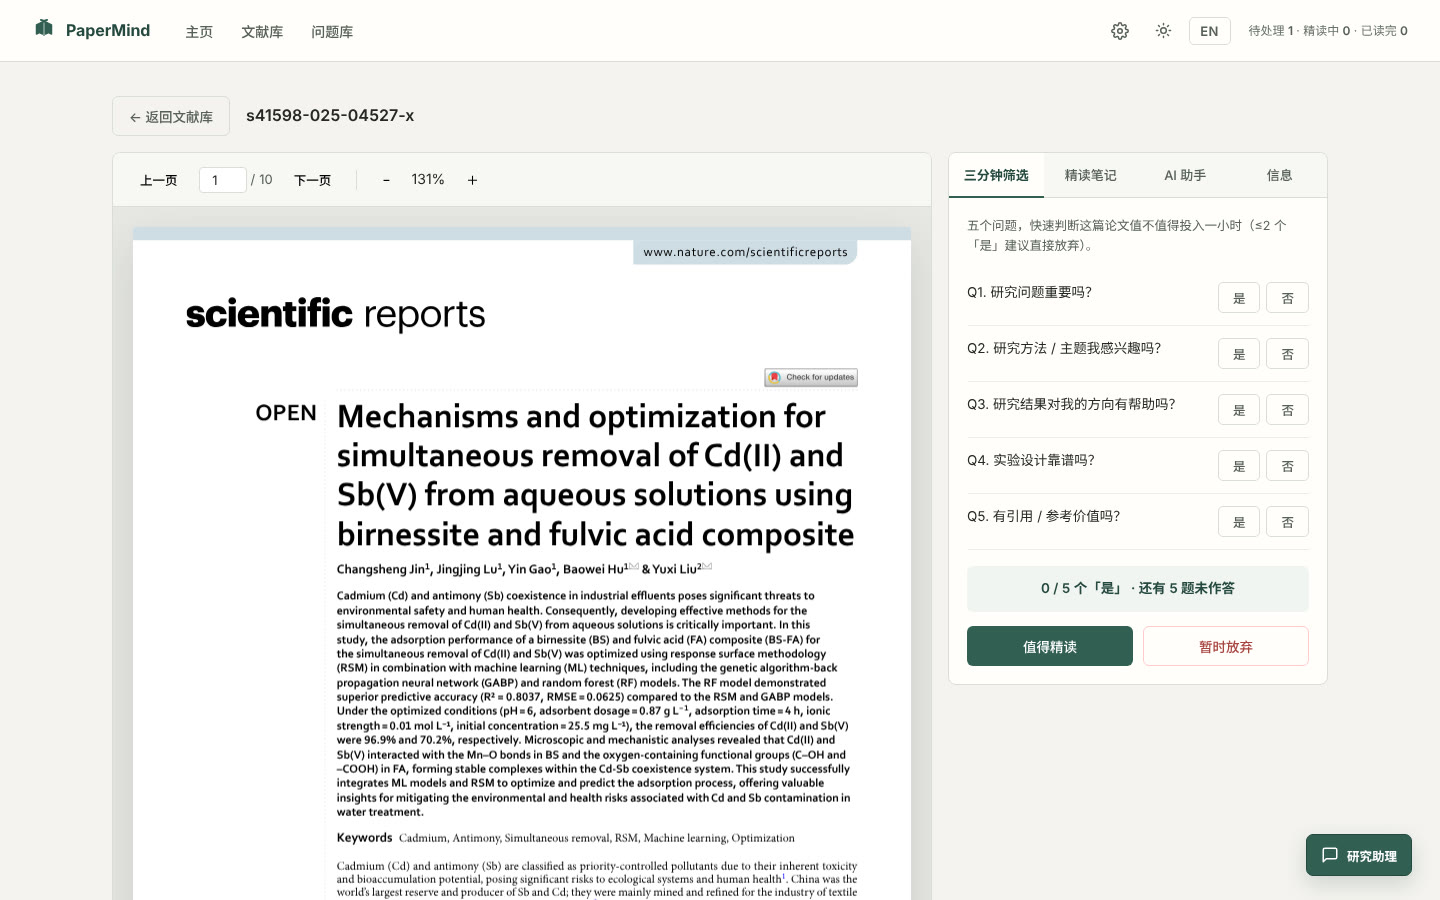
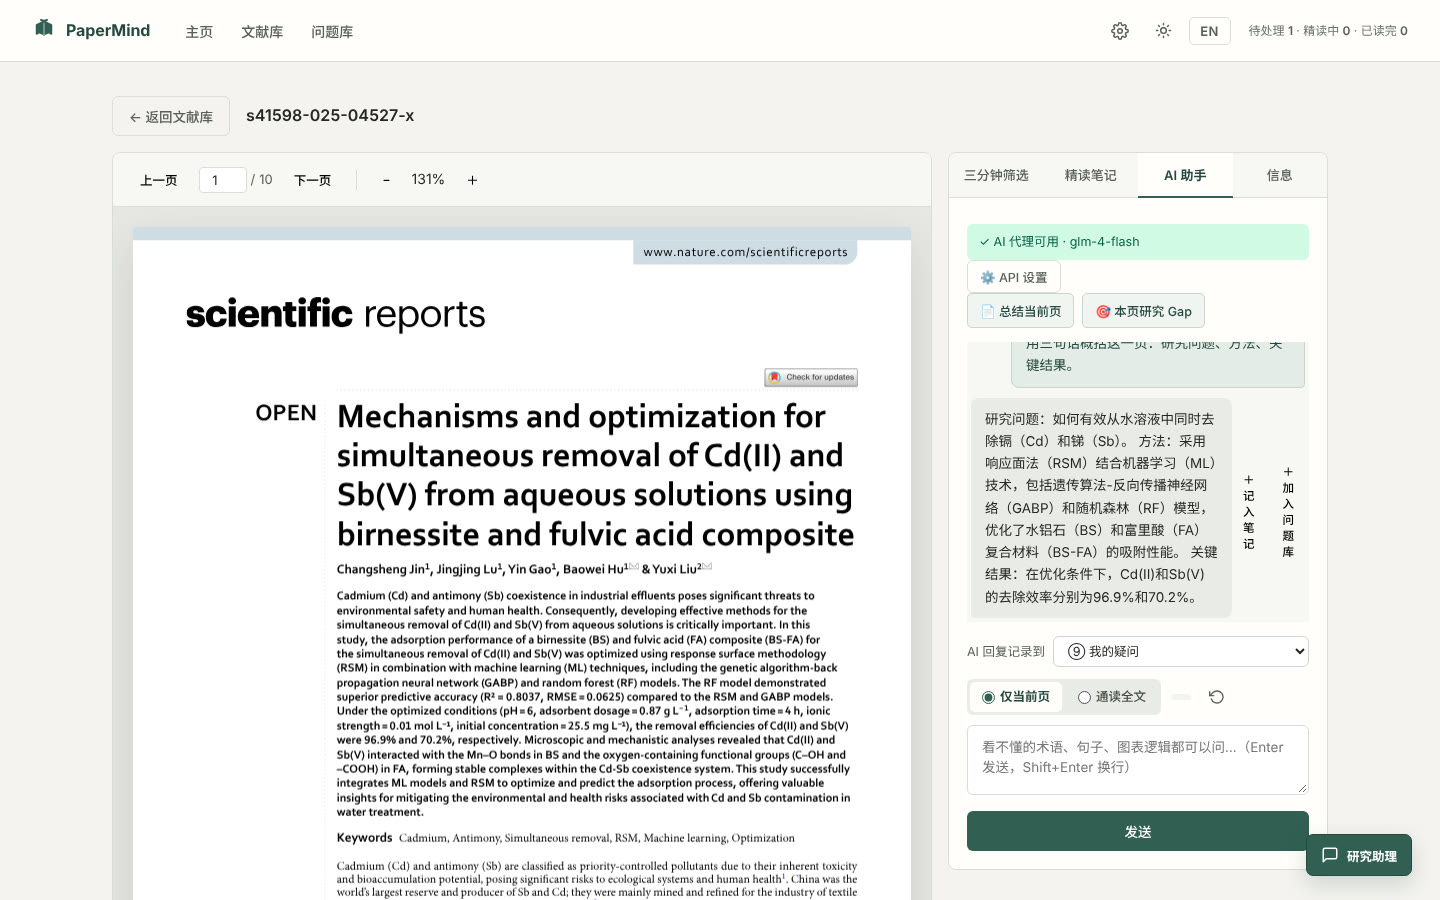
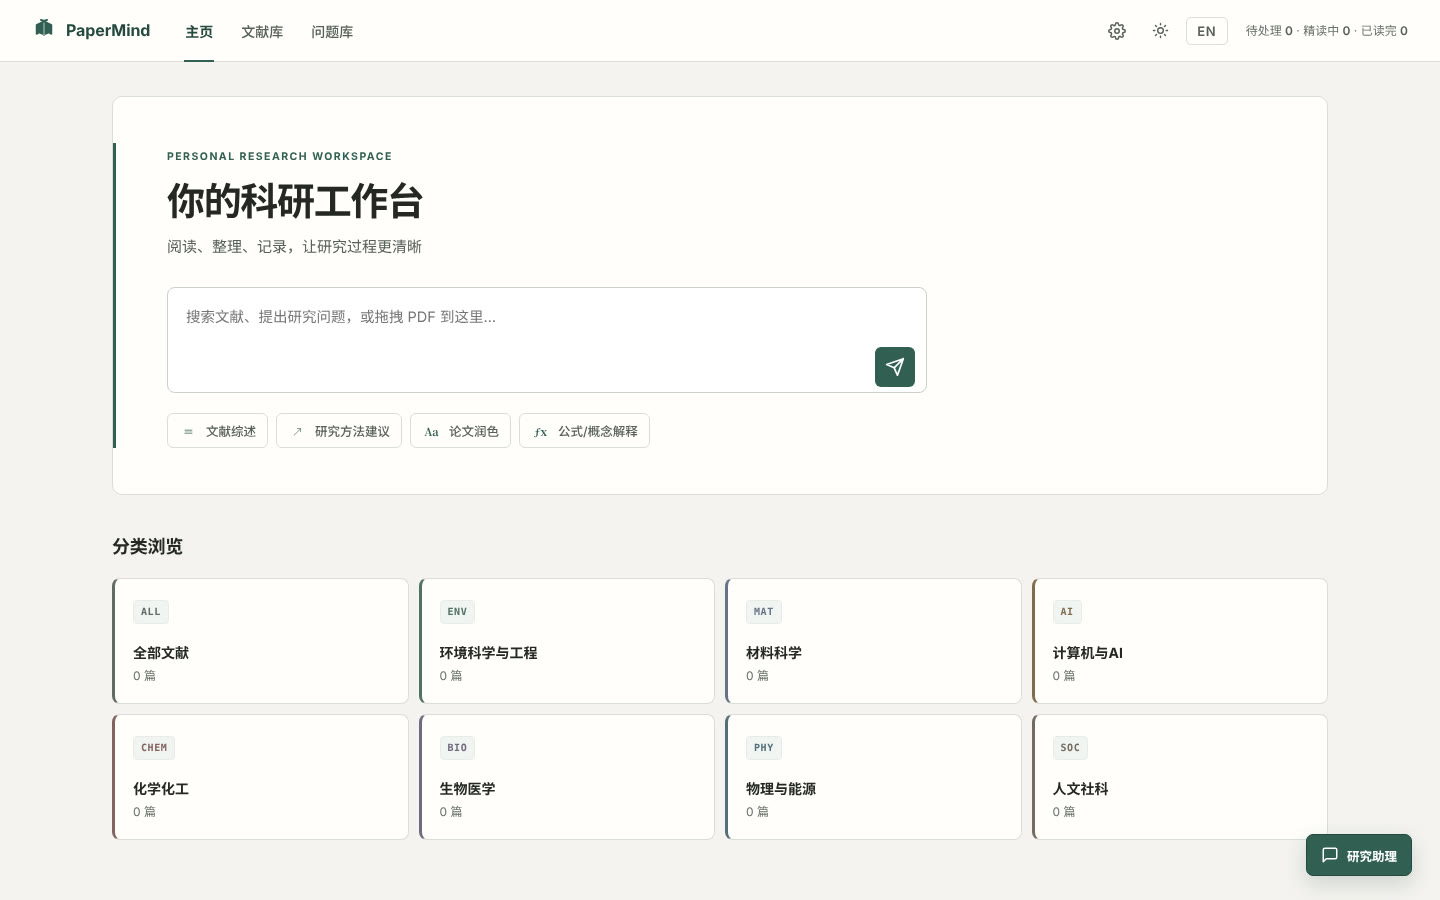
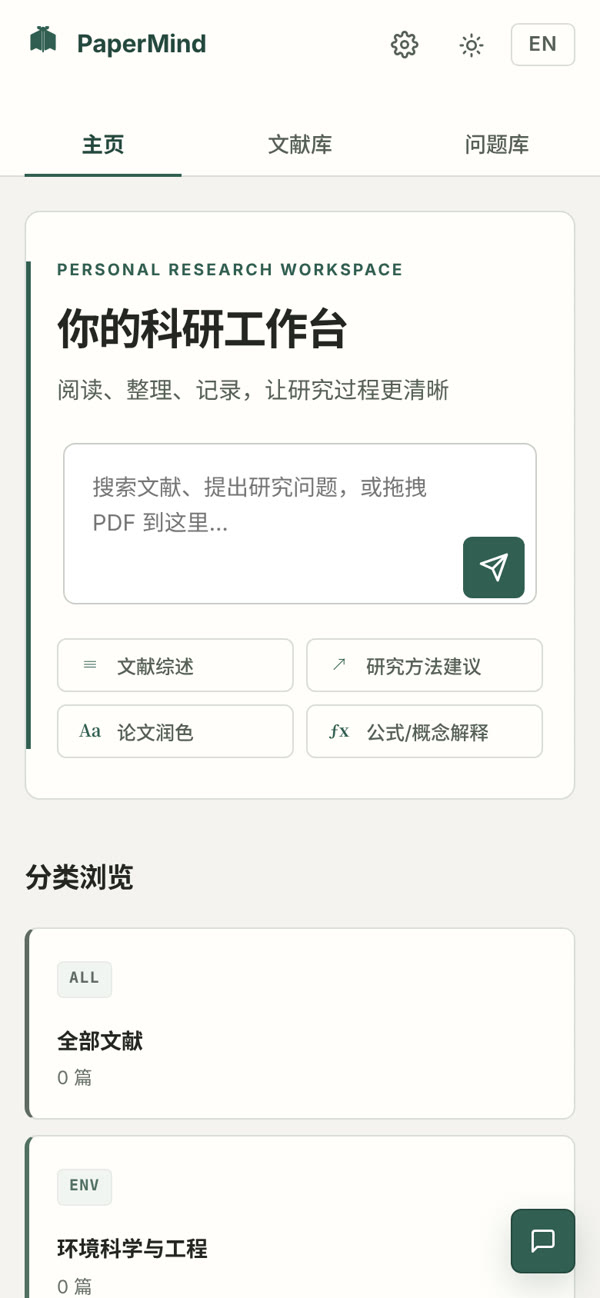
本人工作与 AI 使用
开发中大量使用 AI 编程工具(Codex、Claude、DeepSeek、Trae、WorkBuddy 等)编写代码。本人负责需求拆解、架构与边界设计、验收标准、测试审阅、取舍决定和部署,并让不同 AI 交叉审查。
已知限制
- AI 回答可能有术语误译(例如实测中把 birnessite 译错),界面提示需自行核对
- 共享额度每天有上限,额度用完需在设置里填自己的 Key
- 浏览器数据可能被清理,重要笔记需要导出
源码
暂未公开。需要时可提供代码讲解或现场演示。